- 0
- 1.129 word
O monitoramento não apenas piscou em vermelho; ele sangrou. O Health Score global do Fabric ACI começou a derreter em questão de minutos, a latência do Data Plane disparou e os alarmes de saturação de buffer (Output Drops) começaram a pipocar nas interfaces de downlink dos Leafs conectados aos nossos chassis de lâminas (blades).
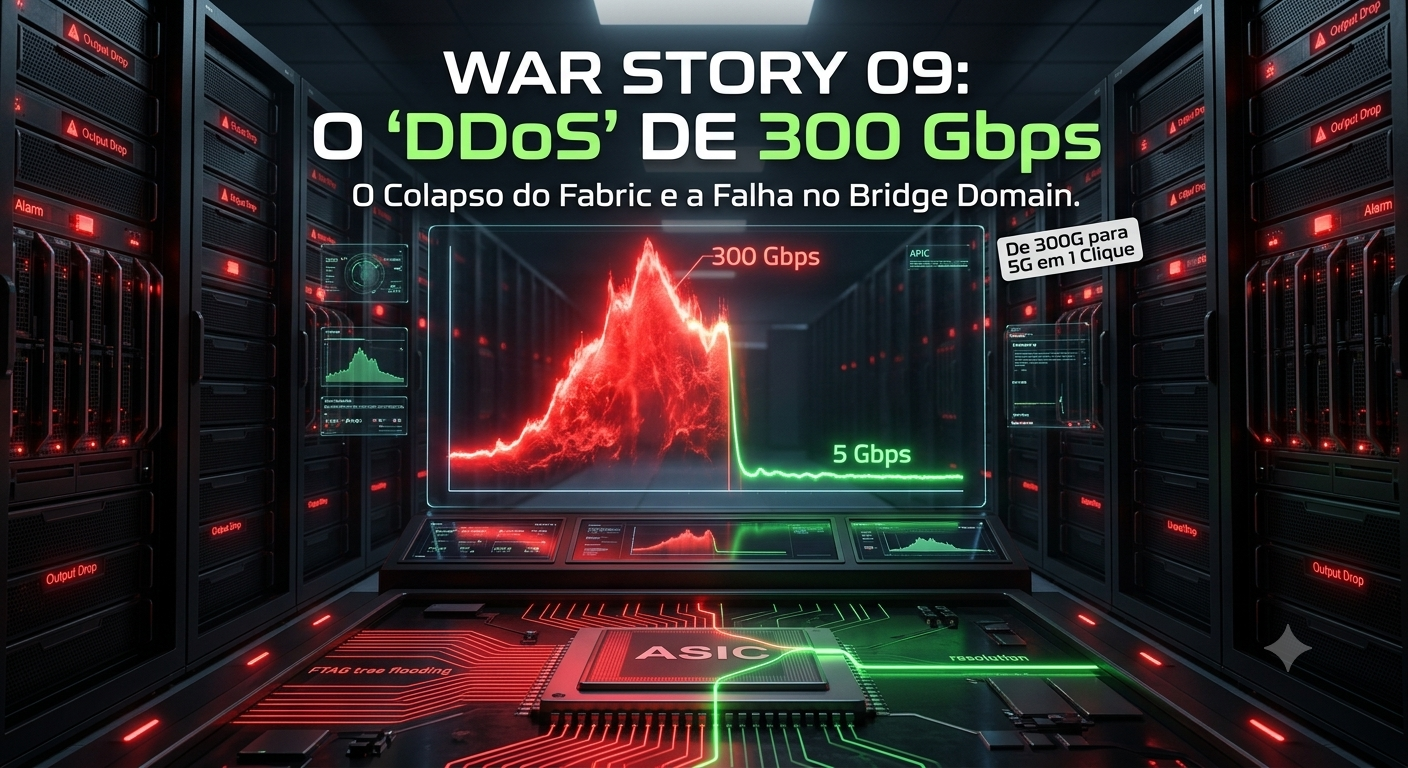
O tráfego total no painel do APIC bateu a marca bizarra e assustadora de 300 Gbps.
A primeira regra de um War Room sob tensão é isolar o domínio de falha. Um tráfego volumétrico dessa magnitude em trânsito leste-oeste (L2/L3 interno) geralmente indica um loop L2 catastrófico ou uma anomalia de replicação. O rastreio do fluxo (Packet Walk mental e auditoria dos Top Talkers) revelou um culpado altamente improvável: nossa própria infraestrutura de backup gerenciada pelo Veeam.
O detalhe crítico? O job do Veeam estava atuando sobre uma VM de backup que possuía interfaces em duas redes distintas. Na origem, o tráfego gerava o seu baseline normal de pesados, porém saudáveis, 1,5 Gbps de throughput.
Como um fluxo lícito de 5 Gbps se transforma em um canhão de 300 Gbps capaz de destruir a saúde do Fabric e enfileirar pacotes até as blades pedirem arrego? A resposta estava na física do hardware (ASIC), em uma falha de design arquitetural herdada, e no peso esmagador da nossa topologia física: os nossos chassis de blades hospedam cerca de 90% de todos os EPGs, BDs e App Profiles do Data Center.
Quando a anomalia de rede atingiu essas blades, a saturação foi tão massiva que a saúde de quase toda a infraestrutura despencou simultaneamente, criando uma cortina de fumaça de alarmes generalizados que dificultou incrivelmente a resolução.
Dissecando a Anomalia: O Multiplicador de Tráfego
Para entender o colapso, precisamos olhar para o cabeçalho do pacote e para a Management Information Tree (MIT). No ACI, o tráfego BUM (Broadcast, Unknown Unicast, Multicast) não se propaga livremente como no Spanning Tree tradicional. Ele é encapsulado em VXLAN e jogado em uma árvore de replicação em hardware chamada FTAG (Forwarding Tag) Tree nos Spines.
O tráfego do Veeam estava batendo em domínios antigos que abrangiam nada menos que 300 EPGs espalhados por todo o Fabric.
O erro fatal: esses BDs legados estavam com a flag de IP Routing habilitada.
Quando você ativa o IP Routing (ip_routing=”yes”) em um objeto fvBD, você altera fundamentalmente o comportamento do silício no Ingress Leaf. Você instrui o ASIC a ativar o IP Data-Plane Learning. O switch passa a observar os cabeçalhos de Camada 3 e tenta aprender ativamente os mapeamentos IP-para-MAC para preencher sua Local Station Table (LST) e sinalizar o Spine via protocolo COOP.
Nesse cenário específico, o Ingress Leaf estava recebendo o fluxo denso do Veeam, mas não conseguia resolver o destino final de forma determinística na tabela de roteamento local. Com o aprendizado de IP forçado e o comportamento de Unknown Unicast/ARP Glean ativado no BD, o Leaf tomou a pior decisão em line-rate: Flood.
Ele encapsulou o fluxo de 5 Gbps no VNI Multicast do Bridge Domain e disparou para o Spine. O Spine, seguindo as regras da FTAG Tree, olhou para a topologia e viu a quantidade massiva de EPGs amarrados. A instrução do hardware foi implacável: replique este pacote para todos os Leafs que possuem portas ativas nestes EPGs.
A matemática da destruição ocorreu no silício em nanossegundos:
1,5 Gbps (Origem) x 200 (Multiplicador de Egress Ports/EPGs) = 300 Gbps de Trafego Lixo
Os Egress Leafs começaram a descarregar essa avalanche de pacotes clonados nas portas físicas das blades, que não tinham nada a ver com o tráfego de backup. Como as blades concentram 90% da inteligência do ambiente, as filas de interface estouraram, os buffers se esgotaram e o Fabric começou a dropar pacotes lícitos de produção por pura exaustão (Head-of-Line Blocking).
A Charada dos Dois BDs e o Bisturi no Control Plane
O ponto de virada no troubleshooting ocorreu quando consegui ignorar o “mar de alarmes” globais e foquei estritamente na árvore de replicação do tráfego. Apesar de o Fabric inteiro estar gerando alarmes para serviços críticos, notei que o flood massivo de pacotes de backup estava, na verdade, originando-se e restrito a apenas dois Bridge Domains específicos (justamente as duas redes nas quais a VM de backup estava conectada).
Ao ver que o flood se isolava nesses dois BDs, matei a charada. Todo o resto era apenas efeito colateral da saturação das blades.
Identificada a classe fvBD e o processo de aprendizado anômalo, a resolução não exigiu desligar interfaces físicas, alterar roteamento externo ou quebrar o job de backup. Exigiu precisão cirúrgica na API do APIC.
Acessei as configurações dos dois Bridge Domains em questão e desmarquei a flag de IP Routing (desativando o roteamento L3 e o IP Learning forçado para aquele domínio).
O impacto de uma mudança no Control Plane do ACI é imediato. Assim que o APIC fez o push da alteração, o Policy Manager dos Leafs reescreveu a tabela TCAM local. O Ingress Leaf parou instantaneamente de tentar aprender os IPs daquele fluxo de backup e encerrou a inundação (flood) para o restante do Fabric. O BD passou a operar estritamente na sua função de repasse L2 esperado para aquele fluxo.
No painel de monitoramento, o gráfico de tráfego leste-oeste despencou em um penhasco vertical. Os 300 Gbps derreteram de volta para os 5 Gbps originais unicast.
As blades voltaram a respirar, os contadores de Drop estabilizaram, e o Health Score do Data Center subiu para 99% em menos de dois minutos.
Lições da Engenharia de Silício
A maior virtude de uma arquitetura Software-Defined é a abstração, mas o seu maior perigo é a ignorância sobre o que a abstração faz no hardware.
Um simples checkbox na interface gráfica ou uma linha ‘ip_routing’: ‘yes’ no seu script Ansible não é apenas uma configuração administrativa. É uma instrução direta ao ASIC (Cloud Scale/Northstar) de como ele deve tratar cada frame de dados no fio de fibra ótica.
Quando você tem ferramentas poderosas como o ACI, os erros não quebram apenas uma porta; eles se multiplicam na velocidade do silício. A estabilidade de um Data Center não depende de reiniciar equipamentos na sorte, mas de dominar o comportamento do pacote em cada estágio do Data Plane. Um clique consciente economiza horas de pânico.
Autor

contato@clubedcaci.com.br
Posts relacionados
War Story 08: Troubleshooting de Multi-Pod Bring-up (Back-to-Back) – Da Análise de Logs à Consistência da MIT
- 0
- 1.016 word
Contexto de Atuação: Fui acionado neste projeto para atuar de forma independente no papel de auditoria técnica e malha de segurança. Minha...
Leia tudo
War Stories #07: O Mistério do Contrato Liberado: Quando a TCAM diz “Sim” e o Packet-Log diz “Não” (O Efeito QUIC no Cisco ACI)
- 0
- 1.170 word
Imagine a cena: uma tarde tranquila na operação de infraestrutura de rede. Você acabou de implementar ou validar uma regra de acesso...
Leia tudo
War Stories #06: O Bloqueio Fantasma de SSH Pós-Upgrade no Cisco ACI 6.x
- 0
- 59 words
A janela de manutenção (Gemud) está na reta final. O cluster APIC atualizou e está cravado como Fully Fit. Os switches Spines...
Leia tudo
War Stories #05: O Assassino Silencioso do Upgrade para o Cisco ACI 6.x
- 0
- 950 words
Quem opera Data Centers sabe que uma Gemud de atualização do Cisco ACI nunca é apenas um “Next, Next, Finish”. O Fabric...
Leia tudo
War Stories #04: O Mistério do vMotion Lento e o Spanning Tree no Cisco Nexus
- 0
- 824 words
No universo de Data Center, existe uma regra não escrita: quando a rede e a virtualização se encontram, o diabo mora nos...
Leia tudo
War Story #03 | O Túnel SD-WAN Fantasma e a Ilusão da Interface Gráfica
- 0
- 678 words
Toca o alerta para entrar numa sala de guerra. O cenário relatado: o Hub SD-WAN (Viptela) precisava alcançar o Firewall de Internet....
Leia tudo